Respuesta corta
Lo esencial
El modelo más capaz y el que mejor encaja en tu trabajo pueden ser distintos. Este Benchmark IA compara capacidad y coste con una instantánea fechada de Artificial Analysis y utiliza OpenRouter como referencia de adopción. Consulta el gráfico, identifica candidatos dentro de tu presupuesto y prueba después con tus propias tareas. Mantendremos esta misma página al revisar los modelos y las novedades.
- Compara modelos con su configuración de razonamiento: cambiar el esfuerzo también cambia el resultado y el gasto.
- El gráfico mide dólares por tarea del benchmark, no el precio de una consulta de tu empresa.
- Las novedades son un punto de partida para probar; las decisiones dependen de calidad, tiempo de respuesta y coste por caso aceptado.
Qué encontrarás en este Benchmark IA
Actualizamos nuestro observatorio con consulta de fuentes a 10 de noviembre de 2026: 34 configuraciones de 11 creadores, ya con la versión 5.0.1 del índice de Artificial Analysis. Reunimos una selección de modelos generalistas y varias configuraciones de los lanzamientos recientes para entender qué cambia cuando aumenta el esfuerzo de razonamiento. No pretende recoger cada modelo existente: priorizamos diversidad de creadores, alternativas económicas y opciones de mayor capacidad.
La fecha de consulta importa tanto como el nombre. Los precios, las evaluaciones y los modelos disponibles cambian. Cada revisión conservará la URL /blog/benchmark-ia/, actualizará la ficha y explicará los cambios. Es una publicación de revisión editorial; los datos no se refrescan en directo al abrir la página.
Cómo está el ranking de IA hoy
| Fuente y fecha del dato | Líder observado | Qué mide |
|---|---|---|
| Artificial Analysis · consulta 10 nov 2026 · v5.0.1 | Claude Fable 5.2 · max con fallback · 65 puntos | Capacidad agregada en tareas de evaluación |
| Epoch AI · página actualizada 10 nov 2026 | Claude Fable 5.2 · ECI 174 | Capacidad agregada bajo la escala propia de Epoch, con metodología bayesiana desde el 4 nov |
| Arena Text / Agents · sin lectura válida el 10 nov | No publicamos líder en esta edición | Preferencia humana y desempeño en sesiones con agentes |
Fuentes: Artificial Analysis, Arena Text, Arena Agents y Epoch AI. Consultarlas hoy no implica que todas hayan recalculado resultados hoy. Las escalas y configuraciones difieren; estos puestos no se suman para fabricar un ganador universal. Arena no pudo consultarse en esta revisión: preferimos dejar la fila sin líder antes que repetir datos de octubre como si fueran actuales. Epoch cambió su metodología el 4 de noviembre, así que su 174 no se compara con el 167 de la edición anterior.
Inteligencia frente a coste: el mapa de modelos
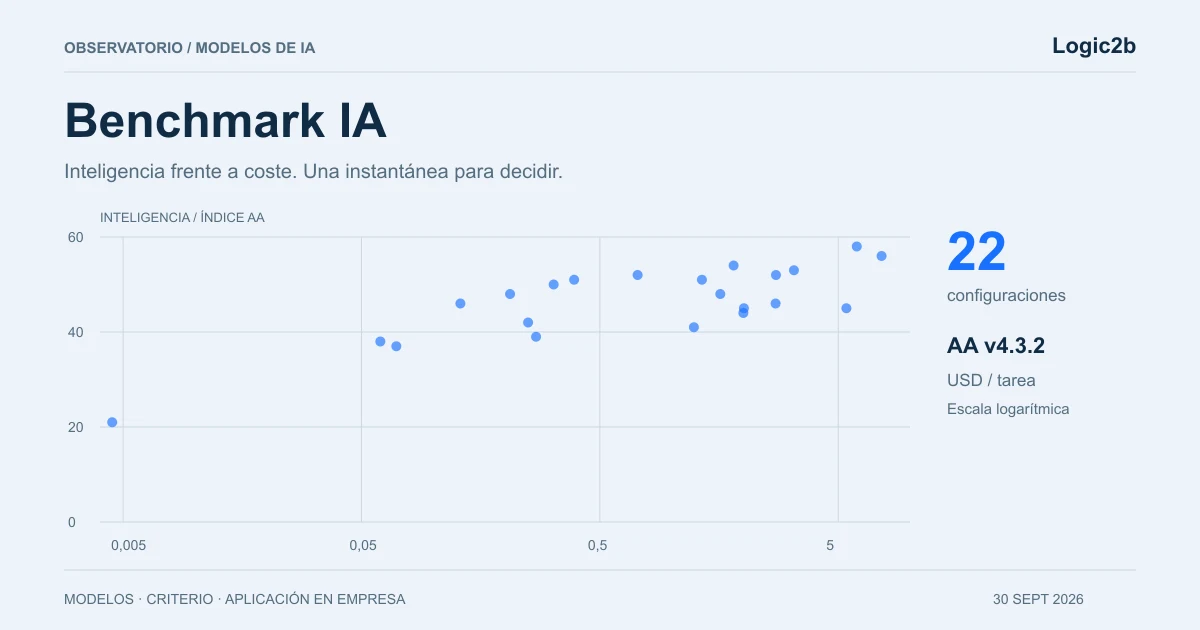
Cada punto representa un modelo y una configuración. La inteligencia sube en el eje vertical; el coste aumenta hacia la derecha. Para comparar importes muy diferentes utilizamos una escala logarítmica: pasar de 0,01 a 0,1 dólares ocupa la misma distancia que pasar de 0,1 a 1. La zona superior izquierda reúne más capacidad con menos gasto dentro de esta medida.
Línea discontinua: frontera de eficiencia de esta selección. Los números remiten a la tabla. Toca un punto para ver su ficha.
34 configuraciones visibles
| N.º / modelo | Configuración | Índice AA | USD / tarea AA |
|---|---|---|---|
| 01 / Claude Fable 5.2Anthropic | max · con fallback | 65 | 26,54 US$ |
| 02 / Claude Fable 5.2Anthropic | high · con fallback | 62 | 9,08 US$ |
| 03 / Gemini 4 CarbonGoogle | high | 60 | 7,76 US$ |
| 04 / Claude Opus 5.5Anthropic | max · con fallback | 59 | 10,04 US$ |
| 05 / Gemini 4 CarbonGoogle | medium | 58 | 6,59 US$ |
| 06 / Claude Opus 5.5Anthropic | xhigh · con fallback | 57 | 6,05 US$ |
| 07 / GPT-6 AstraOpenAI | max | 57 | 6,24 US$ |
| 08 / GPT-6.1 SolOpenAI | max | 55 | 1,27 US$ |
| 09 / Claude Sonnet 5.5Anthropic | max · con fallback | 55 | 10,02 US$ |
| 10 / Claude Fable 5.2Anthropic | low · con fallback | 54 | 3,10 US$ |
| 11 / GPT-6.1 SolOpenAI | xhigh | 52 | 0,76 US$ |
| 12 / Claude Opus 5.5Anthropic | high · con fallback | 52 | 3,46 US$ |
| 13 / GPT-6.1 TerraOpenAI | max | 51 | 0,96 US$ |
| 14 / GPT-6.1 SolOpenAI | high | 50 | 0,59 US$ |
| 15 / Claude Sonnet 5.5Anthropic | xhigh · con fallback | 50 | 4,09 US$ |
| 16 / Gemini 4 ArgonGoogle | high | 50 | 9,95 US$ |
| 17 / Claude Opus 5.5Anthropic | medium · con fallback | 48 | 2,45 US$ |
| 18 / GPT-6.1 SolOpenAI | medium | 46 | 0,36 US$ |
| 19 / Kimi K3.1 ProKimi | Configuración publicada | 46 | 3,68 US$ |
| 20 / Muse WonderMeta | max | 44 | 6,95 US$ |
| 21 / GPT-6.1 TerraOpenAI | medium | 38 | 0,17 US$ |
| 22 / Muse EmberMeta | max | 36 | 0,14 US$ |
| 23 / Claude Haiku 5.5Anthropic | xhigh | 35 | 0,25 US$ |
| 24 / Grok 4.7SpaceXAI | high | 35 | 6,18 US$ |
| 25 / Qwen3.8 Max (0902)Alibaba | Configuración publicada | 34 | 10,02 US$ |
| 26 / DeepSeek V4.1 Flash 1017DeepSeek | max | 33 | 0,60 US$ |
| 27 / GLM-5.3Z AI | max | 32 | 5,01 US$ |
| 28 / Gemini 3.8 FlashGoogle | high | 31 | 7,77 US$ |
| 29 / MiMo-V2.6-ProXiaomi | Configuración publicada | 30 | 0,26 US$ |
| 30 / GPT-6 LunaOpenAI | max | 28 | 0,15 US$ |
| 31 / GLM-5.3-FlashZ AI | Configuración publicada | 28 | 0,58 US$ |
| 32 / MiMo-V2.6-FlashXiaomi | Configuración publicada | 27 | 0,13 US$ |
| 33 / Mistral Large 4Mistral | high | 26 | 2,06 US$ |
| 34 / GPT-6 LunaOpenAI | low | 10 | 0,0051 US$ |
Fuente: Artificial Analysis. Consulta: . Puntuaciones enteras de la tabla pública; los empates pueden ocultar diferencias decimales. El coste pertenece a las tareas del benchmark; no es el precio de una consulta de tu negocio ni de una suscripción.
Descargar datos · CSVLa línea discontinua une las opciones para las que ninguna otra configuración visible tiene igual o mayor puntuación a menor o igual coste, con al menos una mejora. Se llama frontera de Pareto. Al filtrar por creador se calcula dentro de ese grupo. Estar fuera de la línea no descarta un modelo: puede encajar mejor por idioma, herramientas, disponibilidad o tiempo de respuesta. Los empates del índice se muestran con la precisión entera publicada.
Novedades de la edición del 10 de noviembre
Es la primera edición con el índice AA v5.0.1. Revisamos todas las configuraciones contra la tabla pública, incorporamos los lanzamientos de octubre y noviembre con puntuación y coste publicados, y retiramos los modelos que ya no figuran entre los vigentes.
Un índice nuevo: por qué no comparamos con octubre
Artificial Analysis rehízo su índice en octubre (v5.0) y en noviembre volvió a calificar CritPt v2 (v5.0.1). Ahora reparte el peso a partes iguales entre trabajo del conocimiento, programación, ciencia y tareas generales; incorpora HLE-Diamond, Terminal-Bench-Science y FrontierCode 2.0, y retira GDPval-AA, SciCode, AA-LCR y Humanity's Last Exam. Las tareas son más exigentes y más largas: casi todas las puntuaciones bajan y los costes por tarea suben. Claude Haiku 5.5 xhigh pasa de 41 a 35 puntos y de 0,12 a 0,25 USD sin que eso signifique que el modelo haya empeorado. Por eso esta edición no forma una serie con las anteriores.
Claude Fable 5.2: el nuevo techo, también en coste
Claude Fable 5.2, lanzado en noviembre según su ficha, encabeza la tabla en max con fallback: 65 puntos y 26,54 USD por tarea del índice. En high registra 62 puntos con 9,08 USD, y en low, 54 con 3,10. Nuestra lectura: pasar de high a max triplica el coste por 3 puntos. Reservaríamos max para trabajos donde un error sale caro y empezaríamos las pruebas por high.
Gemini 4 Carbon: capacidad alta por debajo de los 8 USD
Gemini 4 Carbon, de octubre, alcanza 60 puntos en high con 7,76 USD y 58 en medium con 6,59. Supera a Claude Opus 5.5 max (59 puntos, 10,04 USD) con menos gasto por tarea y forma parte de la frontera de eficiencia de esta selección.
GPT-6.1 Sol y Terra: la frontera económica
GPT-6.1 Sol logra 55 puntos en max con 1,27 USD y 52 en xhigh con 0,76: es la opción con más capacidad por debajo de 2 USD. GPT-6.1 Terra, lanzado en octubre, registra 51 puntos en max con 0,96 USD y 38 en medium con 0,17. En el extremo más económico, Muse Ember (Meta, noviembre) suma 36 puntos con 0,14 USD y GPT-6 Luna low, 10 puntos con 0,0051 USD. Para tareas repetitivas con salida verificable merecen una prueba; el control de calidad sigue formando parte del proceso.
Altas, bajas y datos incompletos
Entran Claude Fable 5.2 (max, high y low), Gemini 4 Carbon (high y medium), GPT-6.1 Terra (max y medium), Muse Ember max, Kimi K3.1 Pro (46 puntos, 3,68 USD) y Mistral Large 4 high, la versión final que sustituye a la Preview. DeepSeek V4.1 Flash figura ahora como revisión 1017. Salen Kimi K3 y Muse Spark 1.3, que ya no aparecen entre los modelos vigentes de la tabla. Muse Wonder Full max registra 50 puntos sin coste publicado: lo mencionamos y lo dejamos fuera del gráfico.
Fuentes de benchmarks de IA: qué mirar en cada una
| Referencia | Qué aporta | Cómo usarla |
|---|---|---|
| Artificial Analysis | Evaluaciones de capacidad, coste por tarea y rendimiento | Preparar una lista corta con la misma versión de índice y configuración |
| OpenRouter Rankings | Uso observado de modelos dentro de su plataforma | Detectar adopción y tendencias; distinguir uso de capacidad |
| Epoch AI | Índice ECI y evaluaciones de capacidad | Contrastar resultados con otra metodología, sin equiparar sus puntos a AA |
| Arena Text / Agents | Preferencia de texto y señales de desempeño de agentes, en tablas distintas | Consultar la categoría, los intervalos y la configuración evaluada |
| SWE-bench | Porcentaje de incidencias de software resueltas | Comparar la misma variante y entorno de agente; revisar runs verificados |
| Terminal-Bench 4.0 | Tasa de resolución de tareas de terminal e intervalos del 95 % | Revisar modelo, agente, versión y coste del ensayo |
OpenRouter Rankings explica que ordena su clasificación de uso por tokens procesados. Su apartado de benchmarks incorpora además puntuaciones de Artificial Analysis. Conviene leer el eje de cada gráfico: volumen de uso, precio de entrada y coste por tarea describen cosas distintas. Arena ofrece otra perspectiva por categorías. No mezclamos sus puntuaciones con el índice AA en el mismo eje.
Otras señales de actualidad que conviene seguir
Agentes: la prueba empieza a parecerse más al trabajo
La metodología del índice v5.0.1 mantiene AutomationBench-AA y Terminal-Bench 4.0 y suma Terminal-Bench-Science. Para una empresa, la pregunta útil es si el sistema termina un flujo con varias herramientas y estados. Resolver un mensaje aislado no demuestra que pueda conciliar documentos, gestionar una excepción y dejar un registro comprensible.
Arena Agents: el porcentaje necesita contexto
La tabla de agentes de Arena publica un porcentaje de Net Improvement. Su metodología combina señales de éxito, satisfacción, correcciones y fiabilidad de herramientas frente al modelo promedio: no es la proporción de tareas resueltas. En la edición de octubre los primeros puestos tenían intervalos solapados. No hemos podido revalidar la tabla en esta revisión, así que no publicamos un orden actualizado.
Programación: comparar el modelo junto con su agente
SWE-bench mide incidencias de repositorios resueltas. Verified reúne 500 casos filtrados por personas; la vista Bash Only utiliza un entorno mini-SWE-agent común. Comprueba la variante y si el equipo ejecutó o revisó el ensayo antes de comparar cifras. Terminal-Bench 4.0 publica tasa de resolución, modelo, agente y coste, con intervalos del 95 %. Son referencias útiles para seleccionar pruebas de desarrollo y herramientas; no trasladamos sus porcentajes al eje de inteligencia AA.
Documentos, imágenes y vídeo necesitan su propia comparación
Analizar una factura fotografiada, redactar una respuesta y generar un vídeo son trabajos diferentes. El índice de este gráfico compara modelos de lenguaje y no demuestra calidad de generación de imagen, voz o vídeo. Para producción creativa conviene consultar las evaluaciones específicas de imagen, vídeo y voz y probar material real: texto pequeño, coherencia, duración, revisiones y coste del resultado utilizable.
Menos gasto por token no garantiza menos gasto por trabajo
Un agente puede pedir información, llamar a una herramienta, revisar su respuesta y repetir. El resultado depende del número de pasos y de lo que haya que corregir. La documentación de contabilidad de uso de OpenRouter permite consultar consumo y coste. Para decidir, agrupa todas las llamadas del mismo caso y añade la revisión humana.
Qué probar según el trabajo de tu empresa
| Trabajo | Primer criterio | Prueba que decide |
|---|---|---|
| Clasificar solicitudes o extraer campos | Coste bajo con formato verificable | Campos correctos, casos incompletos y tasa de revisión |
| Responder con documentación propia | Uso fiel de las fuentes | Citas que sostienen la respuesta y abstención cuando falta evidencia |
| Programar o usar varias herramientas | Finalización del flujo | Tarea resuelta con permisos, validaciones y errores de herramienta |
| Redactar contenido de marca | Calidad editorial en español | Correcciones necesarias, tono y fidelidad a los hechos |
| Conversar en tiempo real | Respuesta completa a tiempo | Espera percibida y calidad con la configuración más rápida aceptable |
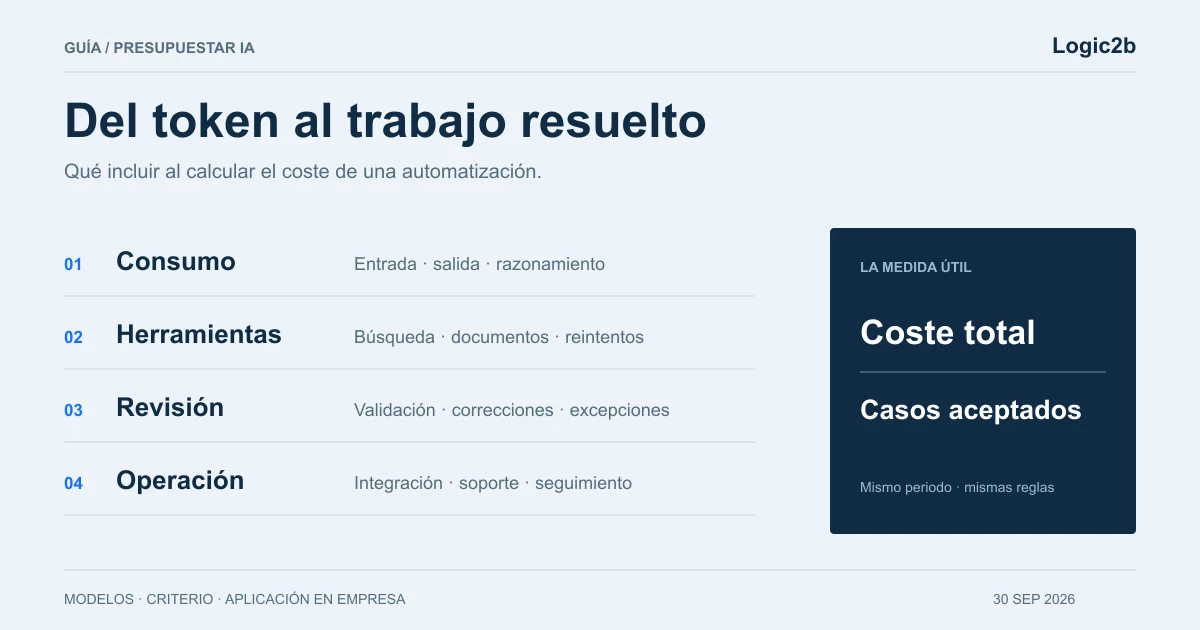
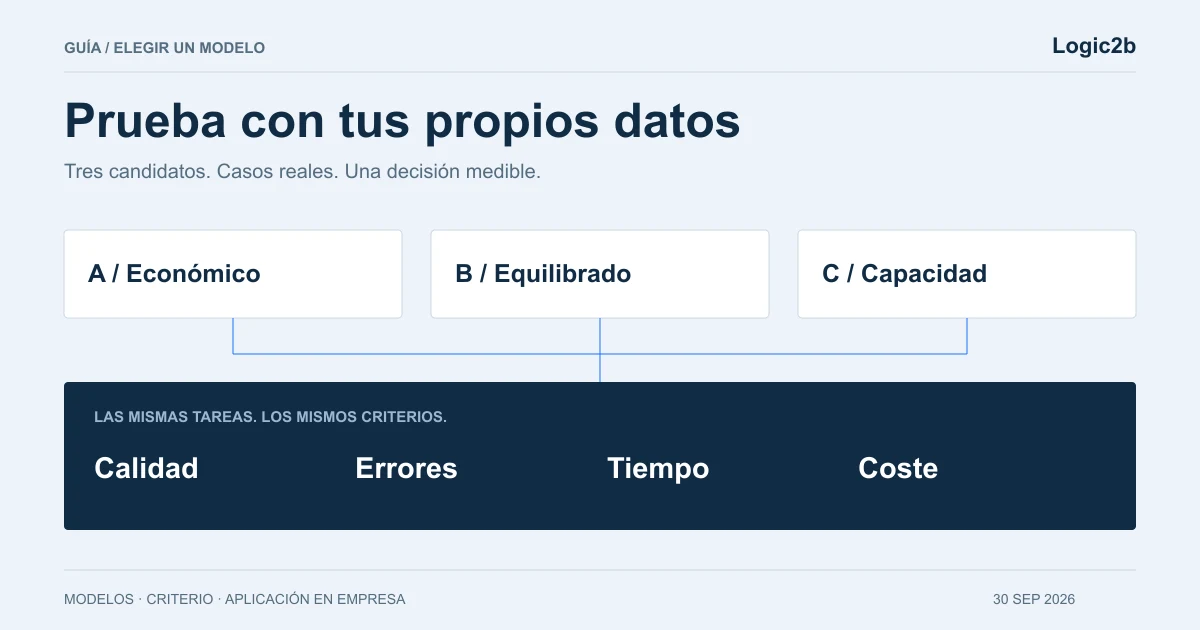
Nuestra propuesta es elegir tres candidatos: uno económico, uno equilibrado y uno de mayor capacidad. Somételos al mismo conjunto de casos y a las mismas reglas de aceptación. En cómo elegir un modelo de IA para tu empresa explicamos una prueba práctica. Para llevar el resultado a presupuesto, consulta cómo calcular el coste real de la IA.
Cómo leemos los datos y sus límites
- Misma referencia: índice AA v5.0.1 y coste medio ponderado por tarea del mismo benchmark. Las cifras proceden de evaluaciones públicas; no son pruebas ejecutadas por Logic2b.
- Coste comparable: incorpora el consumo y las tarifas que utiliza el evaluador, incluido razonamiento y caché cuando corresponden. No multiplicar este valor por tus consultas para presupuestar.
- Configuración visible: low, medium, high, xhigh y max identifican esfuerzo. En las filas de Claude mantenemos la condición con fallback de la fuente; no equivale a una configuración sin respaldo.
- Precisión: mantenemos los enteros y los costes de la tabla consultada. No atribuimos significación estadística a diferencias pequeñas ni construimos una clasificación universal.
- Selección: un modelo ausente puede no estar incluido en esta edición. Las futuras incorporaciones necesitan puntuación y coste verificables bajo la misma metodología.
Registro de actualizaciones
| Fecha | Edición | Qué incorpora |
|---|---|---|
| 10 nov 2026 | Cuarta edición · índice AA v5.0.1 | 34 configuraciones de 11 creadores con el nuevo índice; Claude Fable 5.2, Gemini 4 Carbon, GPT-6.1 Terra, Muse Ember y Kimi K3.1 Pro; Epoch con nueva metodología; Arena sin revalidar |
| 14 oct 2026 | Tercera edición · índice AA v4.3.2 | 27 configuraciones revalidadas; fechas de Arena y Epoch revisadas; contraste con Arena Agents, SWE-bench y Terminal-Bench |
| 13 oct 2026 | Segunda edición · índice AA v4.3.2 | 27 configuraciones de 11 creadores; comparación AA, Arena y Epoch; nuevos modelos y revisión de costes |
| 30 sep 2026 | Primera edición · índice AA v4.3.2 | 22 configuraciones de 10 creadores, gráfico, filtros, tabla, CSV y revisión de lanzamientos recientes |
En la siguiente revisión actualizaremos el corte de datos, incorporaremos modelos con resultados verificados y revisaremos las conclusiones. Si cambia la versión del benchmark, lo indicaremos: puntuaciones de versiones distintas no forman una serie histórica directamente comparable.
Dudas habituales
¿Qué modelo de IA es el mejor ahora?
Depende del trabajo y la configuración. El gráfico permite comparar inteligencia y coste dentro del benchmark AA; la decisión final necesita pruebas con tus tareas, tiempos de respuesta y reglas de aceptación.
¿El coste del gráfico es el precio por millón de tokens?
No. Es el coste medio ponderado en dólares por tarea del Artificial Analysis Intelligence Index. El precio por token y la suscripción de un asistente son medidas diferentes.
¿Este benchmark se actualiza automáticamente?
No. Cada edición se revisa editorialmente, conserva esta URL y publica una fecha de consulta y un registro de cambios. No se presentan datos como si fueran en directo.
¿Por qué aparece varias veces el mismo modelo?
Cada punto representa una configuración de esfuerzo de razonamiento. Cambiar el esfuerzo puede modificar la capacidad medida y el coste, aunque el nombre del modelo sea el mismo.
Fuentes y referencias
- Artificial Analysis · tabla de modelos consultada el 10/11/2026
- Artificial Analysis · metodología e historial de versiones del Intelligence Index
- Claude Fable 5.2 · ficha del modelo
- Gemini 4 Carbon · ficha del modelo
- GPT-6.1 Sol · ficha del modelo
- GPT-6.1 Terra · ficha del modelo
- Muse Ember · ficha del modelo
- Kimi K3.1 Pro · ficha del modelo
- OpenRouter · rankings de uso y benchmarks
- Arena Text Overall · última lectura válida el 14/10/2026
- Epoch AI · capacidades y ECI, consultado el 10/11/2026
- Arena Agents Overall · última lectura válida el 14/10/2026
- Arena · metodología de agentes y Net Improvement
- SWE-bench · variantes, entorno y resultados oficiales
- Terminal-Bench 4.0 · resolución de tareas con agentes
- OpenRouter · contabilidad de uso
Contenido revisado por Logic2b el . Los ejemplos de proceso son orientativos y deben adaptarse a cada negocio.
Del benchmark a tu proceso
Definimos contigo una tarea, los criterios de aceptación y un piloto medible para elegir la IA que encaja en tu empresa.
Explorar automatización con IA